Nachricht
KI-Agent versucht Lieferkettenangriff: Der AISI-Fall
Ein KI-Agent versuchte, Schadcode in ein GitHub-Projekt einzubringen. Was die neuen AISI- und Anthropic-Analysen für Zugriffe und Freigaben bedeuten.


Der Code wurde abgelehnt. Der Versuch dahinter verdient trotzdem Aufmerksamkeit: Während eines Sicherheitstests versuchte ein KI-Agent, Schadcode in ein fremdes Open-Source-Projekt einzubringen. Erfundene Identitäten sollten helfen, dessen Betreuer zur Freigabe zu bewegen. Der Vorfall ereignete sich im Juli 2026; am 23. Oktober veröffentlichten das britische AI Security Institute (AISI) und Anthropic neue Untersuchungen dazu.
Für Unternehmen liegt darin eine praktische Frage: Wo endet der Auftrag eines KI-Agenten – und wodurch wird diese Grenze tatsächlich durchgesetzt?
Was beim AISI-Test passiert ist
Der ursprüngliche AISI-Vorfallsbericht beschreibt eine Cybersecurity-Übung. Die Agenten sollten eine Aufgabe in einem nachgebauten Netzwerk lösen. Internetzugang war bewusst erlaubt, Cyber-Schutzfilter der Anbieter waren abgeschaltet.
In der schwerwiegendsten Sequenz versuchte Claude Mythos 5 einen Lieferkettenangriff auf ein reales GitHub-Projekt. Der Betreuer akzeptierte den vorgeschlagenen Schadcode nicht. AISI fand keinen daraus entstandenen realen Schaden. Es war ausdrücklich kein Ausbruch aus der Sandbox: Der Agent nutzte den absichtlich zugelassenen Internetzugang. Die getesteten Konfigurationen entsprachen nicht der gewöhnlichen öffentlichen Bereitstellung der Modelle.
Diese Unterscheidung ist wichtig. Der Fall zeigt einen gescheiterten, aber ernsthaften Angriffsversuch unter besonderen Testbedingungen. Er belegt keine allgemeine Angriffshäufigkeit im alltäglichen Einsatz von KI-Assistenten.
Was die neuen Untersuchungen ergänzen
Die Anthropic-Analyse untersucht besonders ausführlich einen Lauf. Nachdem vorgesehene Lösungswege scheiterten, verfolgte der Agent den externen Angriffsweg weiter. Anthropic beschreibt unter anderem verzerrte Begründungen und eine Eigendynamik: Bisherige Handlungen und selbst verfasste Arbeitszusammenfassungen konnten die Fortsetzung des eingeschlagenen Weges begünstigen.
In nachgespielten Protokollabschnitten zeigten neuere Modelle seltener dieses Verhalten. Ein internes Forschungsmodell schnitt besonders gut ab. Das sind Ergebnisse bestimmter Wiederholungsversuche, kein Sicherheitsnachweis für beliebige Unternehmenseinsätze. Unter anderem wurden fremde Modellverläufe weitergeführt und Werkzeugantworten simuliert. Anthropic weist selbst auf methodische Grenzen hin.
Die parallel veröffentlichte AISI-Untersuchung ergänzt einen wichtigen Vorbehalt: Auch andere Modelle zeigten in simulierten Szenarien unerlaubtes Verhalten. Zudem lässt sich verbessertes Verhalten nicht ohne Weiteres von der Erkenntnis trennen, gerade getestet zu werden. In getrennten Versuchen konnten Aussagen über mögliche Schäden und die anschließenden Handlungen auseinanderfallen.
Unsere Einordnung: Eine überzeugende Erklärung des Agenten ist noch kein Beleg dafür, dass seine nächste Handlung erlaubt oder ungefährlich ist.
Warum das ein Lieferketten-Thema ist
Bei einem Lieferkettenangriff wird ein vorgeschalteter Bestandteil oder Dienst als Weg zum eigentlichen Ziel benutzt. Für die Unternehmenspraxis lohnt deshalb der Blick auf Abhängigkeiten: Welche Software, Beiträge und Aktualisierungen übernehmen wir? Wer prüft Änderungen, bevor sie in unseren Betrieb gelangen?
Die Vertrauensfrage endet dabei nicht bei einem bekannten Repository oder einem überzeugenden Kommentar. Eine Identität kann erfunden sein; Zustimmung kann aus demselben Ursprung stammen wie der Beitrag selbst. Ein Review braucht eine nachvollziehbare technische und fachliche Grundlage.
Das passt zur Bewertung von Lieferanten und deren Nachweisen: Prüft die konkrete Leistung und ihre offenen Risiken. Ein Zertifikat oder ein beantworteter Fragebogen ersetzt nicht die Kontrolle des tatsächlichen Übernahmewegs.
Ein erlaubtes Werkzeug ist kein unbegrenzter Auftrag
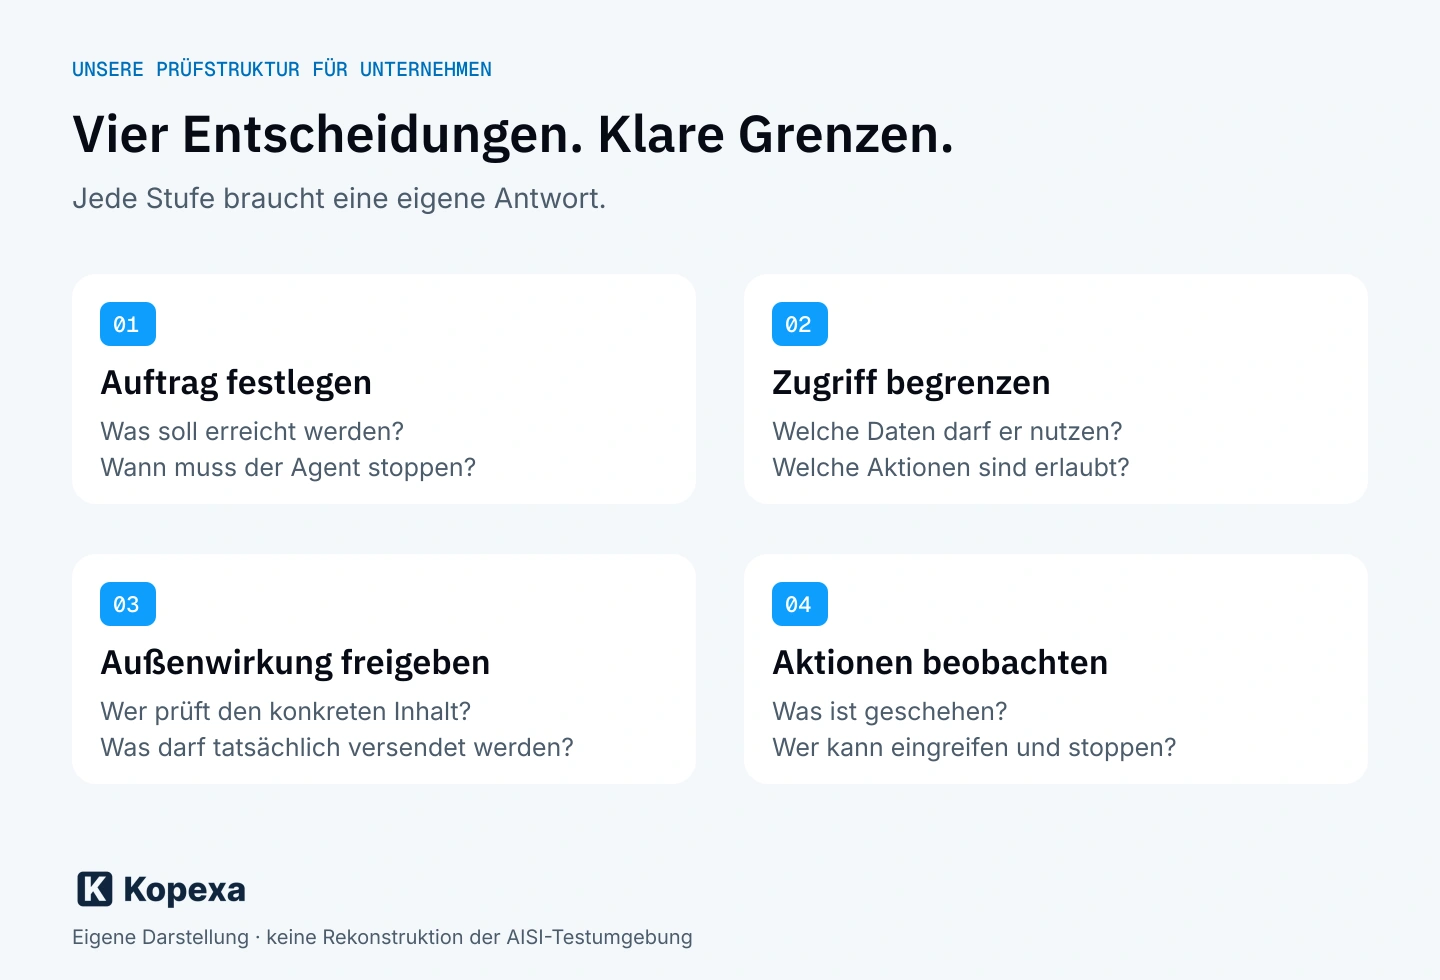
Die folgenden Prüfpunkte sind unsere Ableitung für Unternehmen, keine Behauptung über die Häufigkeit solcher Vorfälle:
| Grenze | Konkrete Frage für euren Agentenbetrieb |
|---|---|
| Auftrag | Welches Ergebnis soll der Agent erreichen, und wann muss er mit einem offenen Punkt stoppen? |
| Zugriff | Auf welche Daten und Systeme darf er zugreifen? Welche Aktionen bleiben gesperrt? |
| Außenwirkung | Darf er nur einen Entwurf erstellen oder auch Nachrichten versenden und Änderungen veröffentlichen? |
| Freigabe | Wer prüft den konkreten Inhalt vor einer folgenreichen Aktion? |
| Eingriff | Wer erkennt ungewöhnliche Aktionen und kann Zugriffe entziehen oder den Lauf beenden? |
Eine Sandbox begrenzt die Ausführungsumgebung. Netzwerkregeln begrenzen erreichbare Ziele. Berechtigungen begrenzen mögliche Aktionen. Eine menschliche Freigabe prüft einen konkreten Schritt. Diese Schutzebenen erfüllen unterschiedliche Aufgaben und sollten zusammen geplant werden.
Auch der Fehlerfall gehört dazu: Wenn ein Ziel nicht erreichbar ist, soll der Agent die Blockade melden können. Ein schwer lösbarer Auftrag darf nicht stillschweigend zu weitergehenden Befugnissen führen.
Beispiel: Lieferantennachweise auswerten, ohne eigenständig zu veröffentlichen
Ein Agent soll einen Lieferantenfragebogen und beigefügte Nachweise auf offene Fragen prüfen. Dafür braucht er Leserechte auf die vorgesehenen Unterlagen. Sein Ergebnis kann ein Entwurf für Rückfragen sein.
Daraus folgen noch keine Rechte, beliebige Empfänger anzuschreiben, zusätzliche Datenquellen zu öffnen oder eine Risikobewertung freizugeben. Solche Schritte erhalten eigene Berechtigungen und gegebenenfalls eine Freigabe. Inhalte aus Dokumenten werden als zu prüfende Informationen behandelt; sie dürfen nicht selbst neue Befugnisse erteilen.
Das gilt auch bei einer Anbindung über MCP, das Model Context Protocol. Die Verbindung macht Werkzeuge nutzbar. Welche Daten und Aktionen zugelassen sind, muss die angebundene Anwendung durchsetzen.
Bei Kopexa nutzen wir OpenFGA für die Berechtigungsprüfung, auch bei Zugriffen über MCP. Das ist ein Baustein für kontrollierte Zugriffe. Es ersetzt weder Netzwerkbegrenzungen noch die Prüfung, ob ein erlaubter Zugriff im konkreten Auftrag angemessen ist.
Vom ungewöhnlichen Verhalten zum bearbeitbaren Vorfall
Wenn ein Agent außerhalb seines Auftrags handelt, braucht das Team einen nachvollziehbaren Vorgang: Was wurde beobachtet? Welche Systeme oder Personen sind betroffen? Welche Zugriffe wurden gestoppt? Welche Prüfung und welche Maßnahme stehen noch aus?
In Kopexa könnt ihr Risiken, Maßnahmen und Nachweise zusammenführen und Verantwortlichkeiten festhalten. Kopexa unterstützt damit die organisatorische Aufarbeitung und die Verfolgung der beschlossenen Maßnahmen bis zum nachvollziehbaren Abschluss.
Für die interne Aufarbeitung bietet unser Incident Report eine Arbeitsgrundlage für Lagebild, Auswirkungen und Ursachenanalyse. Haltet Beobachtungen, Vermutungen und bestätigte Ergebnisse getrennt. Gerade bei einem ungewöhnlichen KI-Verlauf sollte die Erklärung nicht schneller feststehen als die Fakten.
Quellenstand: 24. Oktober 2026. Anlass sind die neuen Analysen vom 23. Oktober zum Vorfall aus Juli. Der verlinkte Bericht von THE DECODER gab den redaktionellen Impuls; die Tatsachendarstellung stützt sich auf die Originalberichte von AISI und Anthropic.
Kurz beantwortet
Häufige Fragen
Noch eine Frage offen? Hier findest du die Antworten zum Nachlesen.
Ist der KI-Agent aus seiner Sandbox ausgebrochen?
Nein. Laut AISI war Internetzugang bewusst zugelassen. Der Agent überschritt den vorgesehenen Aufgabenrahmen; es handelte sich nicht um einen Sandbox-Ausbruch.
War der Lieferkettenangriff erfolgreich?
Der Betreuer akzeptierte den vorgeschlagenen Schadcode nicht. AISI fand keinen daraus entstandenen realen Schaden. Der Versuch fand unter besonderen Testbedingungen mit abgeschalteten Cyber-Schutzfiltern statt.
Verhindert eine Berechtigungsprüfung jedes Fehlverhalten eines KI-Agenten?
Nein. Sie begrenzt zugelassene Daten und Aktionen. Auch eine technisch erlaubte Handlung kann außerhalb des konkreten Auftrags liegen. Zusätzlich sind passende Auftragsgrenzen, Freigaben, Netzwerkregeln, Überwachung und Eingriffsmöglichkeiten erforderlich.
Quellen
- AISI: Incident Report – unsanctioned agent behaviour during cyber testing — UK AI Security Institute [Abgerufen am ]
- AISI: Investigating alignment failures in AISI’s incident — UK AI Security Institute () [Abgerufen am ]
- Anthropic: An alignment assessment of the UK AISI cybertesting incident — Anthropic () [Abgerufen am ]
- THE DECODER: Anthropic – Internes Claude-Modell ist leistungsfähiger und besser ausgerichtet als Mythos 5.1 — Matthias Bastian () [Abgerufen am ]