Nachricht
Kubernetes plant Workload Conformance: Was hält deine Anwendung aus?
Kubernetes plant gemeinsame Laufzeittests für Anwendungen. Was Workload Conformance ändern soll, was Kyverno heute kann und wo native Prüfungen ihre Grenzen haben.
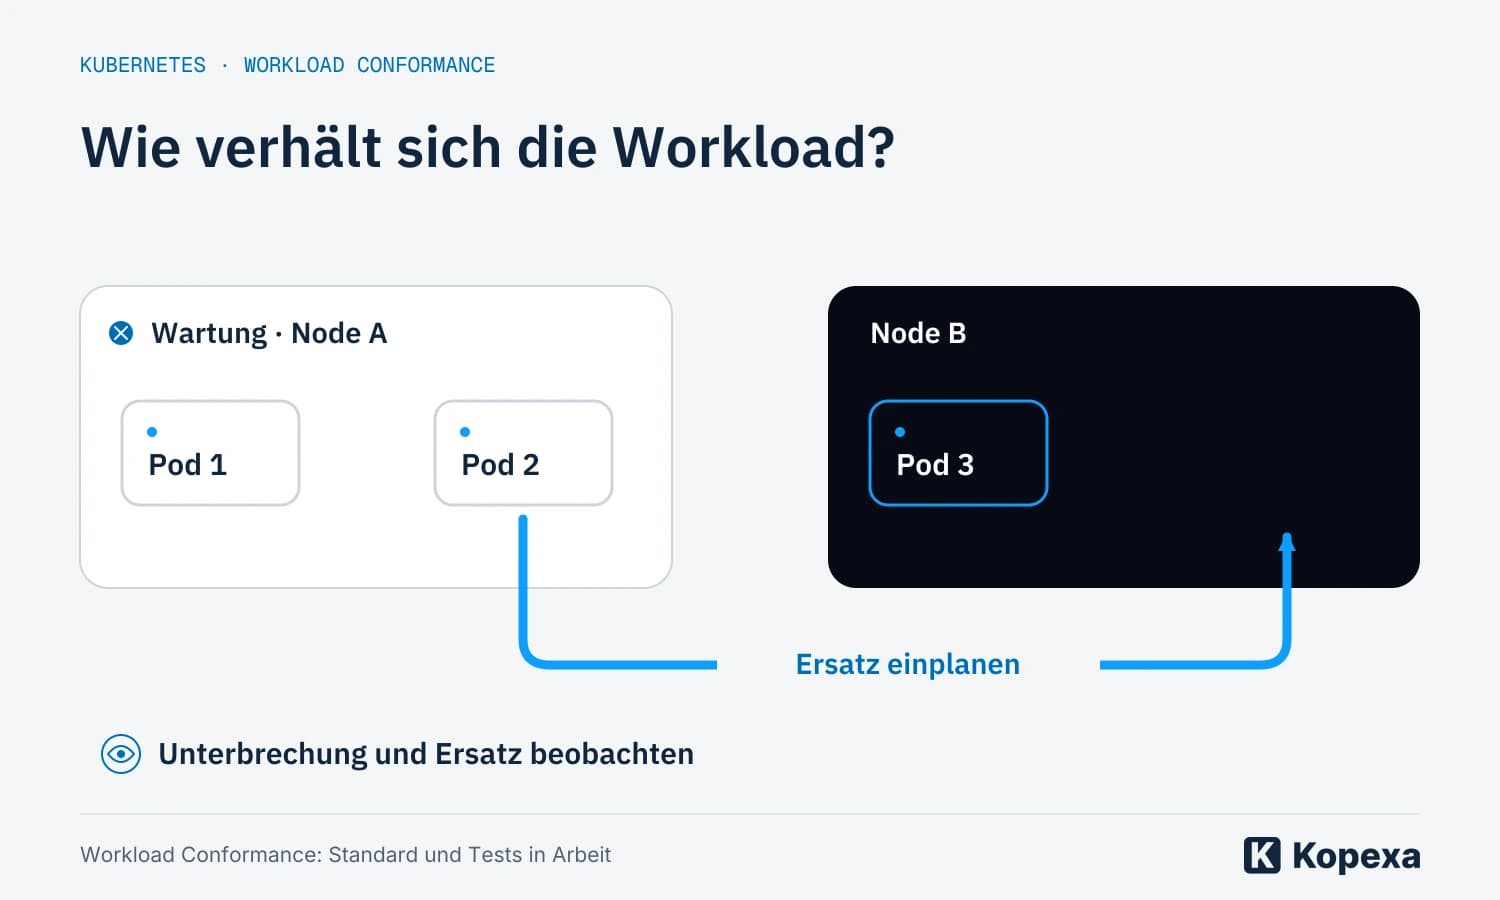
Ein Wartungsfenster beginnt. Ein Node soll geleert werden, damit der Betreiber ihn aktualisieren kann. Für die Anwendung ist das ein praktischer Architekturtest: Sind andere Instanzen verfügbar? Können Ersatz-Pods starten? Beenden die alten Instanzen ihre laufende Arbeit sauber?
Genau solche Betriebsfragen will die Kubernetes-Community künftig auf einer gemeinsamen Grundlage prüfen. Am 27. Oktober 2026 hat sie die Workload Conformance Working Group öffentlich angekündigt. Das Vorhaben betrifft die Anwendungen auf dem Cluster und könnte die Zusammenarbeit zwischen Plattformteams und Softwareherstellern verändern.
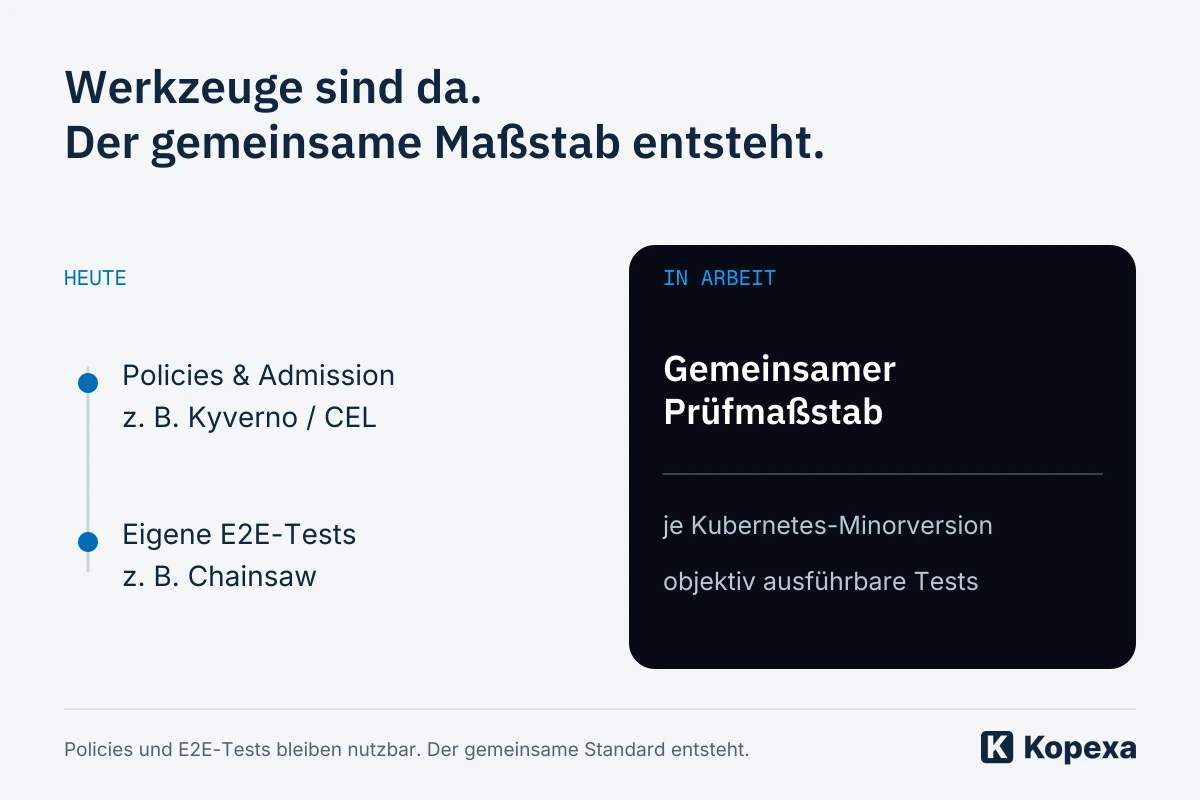
Der interessante Fortschritt wäre ein gemeinsamer Prüfvertrag. Werkzeuge wie Kyverno und Chainsaw ermöglichen bereits heute umfangreiche Regeln und Tests. Neu wäre eine upstream abgestimmte Antwort darauf, welche Laufzeiteigenschaften eine Workload für eine bestimmte Kubernetes-Version erfüllen soll. Ein fertiges, automatisch eingebautes Prüfwerkzeug wurde bisher nicht angekündigt. Kubernetes-Ankündigung
Das Wichtigste
- Geplant sind ein versionsbezogener Standard, Prüfverfahren und passende Upstream-Testwerkzeuge.
- Konkrete Anforderungen und Testmethoden sind noch offen. Zwei bis drei Kubernetes-Releasezyklen sind das Projektziel für einen ersten stabilen Stand.
- Kyverno, Chainsaw und vorhandene Kubernetes-Mechanismen bleiben relevante Bausteine.
- Der mögliche Mehrwert liegt in gemeinsam definierten Tests und vergleichbareren Aussagen zwischen Herstellern und Betreibern.
- Upstream bedeutet hier nicht automatisch im API-Server oder kubelet eingebaut. Ein Zertifizierungsprogramm ist ebenfalls noch nicht gestartet.
Redaktionsstand: 29. Oktober 2026. Die Nachricht ist eine Ankündigung mit technischer Einordnung. Die späteren Praxisbeispiele sind unsere eigenen Vorbereitungsvorschläge, kein bereits beschlossener Testkatalog der Arbeitsgruppe.
Was Kubernetes mit Workload Conformance vorhat
Die Arbeitsgruppe soll eine Spezifikation für jede Kubernetes-Minorversion, objektive Prüfmethoden an laufenden Workloads und entsprechende Werkzeuge entwickeln. Damit würden Plattformbetreiber und Anwendungshersteller eine gemeinsame Referenz für das erwartete Betriebsverhalten bekommen. Die öffentliche Ankündigung nennt noch keine zugesagte Zielversion für die Auslieferung.
Die Charter umfasst unter anderem Security, Widerstandsfähigkeit bei Unterbrechungen, Ressourcenverbrauch, Netzwerk, Storage, API-Nutzung und Beobachtbarkeit. Sie legt zugleich Grenzen fest: Die fachliche Anwendungslogik gehört nicht zum Prüfgegenstand. Ein bestimmtes Paketformat, eine bestimmte Policy Engine oder ein Herstellerprodukt sollen nicht Voraussetzung sein.
Spezifikation und Werkzeuge sind für ein künftiges Subprojekt unter SIG Architecture vorgesehen; SIG Apps bringt die Anwendungsperspektive ein. Ein mögliches späteres CNCF-Zertifizierungsprogramm wäre ein gesonderter Schritt nach Stabilisierung und Freigabe des Standards. Aus der heutigen Ankündigung lässt sich daher weder ein verfügbares Zertifikat noch eine neue Kubernetes-API ableiten.
Warum ein Node Drain so viel über eine Anwendung verrät
Beim Node Drain wird ein Node für neue reguläre Einplanungen gesperrt und seine dafür vorgesehenen Pods werden kontrolliert entfernt. Die zuständigen Controller können Ersatz-Pods erstellen. Ein Pod wird dabei nicht als unverändertes Objekt auf einen anderen Node verschoben. Der dokumentierte Drain-Ablauf berücksichtigt unter anderem die zulässigen Evictions und die Beendigung der betroffenen Pods.
Das ist alltägliche Wartung mit mehreren beteiligten Mechanismen: Scheduling, freie Kapazität, Storage-Anbindung, Bereitschaft der Anwendung und ihr Verhalten beim Beenden. Schon deshalb kann eine formal plausible Deployment-Datei das Ergebnis nicht allein vorhersagen.
Ein PodDisruptionBudget ist eine Schutzregel mit begrenztem Auftrag
Ein PodDisruptionBudget, kurz PDB, begrenzt freiwillige Unterbrechungen ausgewählter Pods. Es kann beispielsweise eine Eviction blockieren, wenn danach zu wenige Instanzen verfügbar wären. Das ist unter Umständen genau die gewünschte Schutzwirkung.
PDBs verhindern keine unfreiwilligen Ausfälle wie den Verlust eines Nodes; solche Ausfälle werden allerdings auf das Budget angerechnet. Auch die Rolling Updates eines Workload-Controllers werden nicht durch ein PDB begrenzt. Dafür sind dessen eigene Update-Einstellungen relevant. Kubernetes: Disruptions
Ein eigener Beispielfall: Eine Anwendung hat drei Replikas und ein PDB mit mindestens zwei verfügbaren Instanzen. Nach der ersten Eviction lässt sich der Ersatz-Pod mangels Kapazität nicht einplanen. Weitere Evictions können blockiert bleiben, während die zwei übrigen Instanzen noch arbeiten. Der Betreiber muss jetzt Kapazität, Platzierung und Wartungsablauf klären. Das Budget einfach zu umgehen würde die ursprünglich beabsichtigte Grenze aufheben.
Bereitschaft und Beendigung müssen zur Anwendung passen
Readiness-, Liveness- und Startup-Probes erfüllen unterschiedliche Aufgaben. Eine Readiness-Probe soll steuern, ob eine Instanz für Verkehr bereit ist. Ob der gewählte Endpunkt den benötigten Zustand sinnvoll abbildet, hängt von der Anwendung ab. Ein stets erfolgreicher HTTP-Endpunkt kann beispielsweise wenig über deren nutzbare Abhängigkeiten aussagen. Kubernetes: Probes
Beim regulären Beenden läuft ein konfigurierter preStop-Hook vor dem Stoppsignal. Seine Ausführungszeit verbraucht bereits einen Teil der Grace Period. Lange laufende Arbeit, Verbindungsabbau und die gewählte Frist müssen daher zusammenpassen. Ein zusätzlicher Hook ist kein allgemeines Rezept für jede Anwendung. Kubernetes: Container Lifecycle Hooks
Für einen Test ergeben sich daraus konkrete Beobachtungen: Welche Anfragen liefen während des Übergangs? Wurden Aufträge beendet, kontrolliert wiederholt oder verloren? Wie lange warteten Ersatzinstanzen auf ihre Bereitschaft? Das sind unsere Testideen; welche davon ein künftiger Standard aufnimmt, steht noch nicht fest.
Was Kyverno heute schon leisten kann
Kyverno ist bereits eine Kubernetes-orientierte Policy Engine. Je nach eingesetzter Version und Policy-Typ lassen sich Ressourcen bei der Admission validieren oder verändern. Regeln können außerdem die Erzeugung weiterer Ressourcen auslösen. Unterstützte Prüfungen können auch auf vorhandene Ressourcen angewendet und als Policy Reports ausgewiesen werden. Kyverno: Applying Policies
Das ist für Kubernetes Security unmittelbar nützlich: Betreiber können zulässige Konfigurationen ausdrücken und Abweichungen behandeln, bevor ein neuer Workload regulär arbeitet. Hintergrundberichte ergänzen die Sicht auf bereits vorhandene Ressourcen. Die Grenzen hängen von der jeweiligen Regel, ihrem Ausführungsmodus und dem verfügbaren Kontext ab.
Der offizielle Policy-Katalog enthält beispielsweise Regeln für:
Solche Beispiele muss man genau lesen. Die Probe-Regel verlangt im veröffentlichten Beispiel mindestens eine der genannten Probearten. Sie beweist nicht, dass der Readiness-Endpunkt sinnvoll ist. Die Ressourcen-Regel verlangt Requests und Memory-Limits; daraus folgt keine allgemeine Pflicht zu CPU-Limits. Das PDB-Beispiel hat eigene Voraussetzungen und darf nicht ungeprüft als universelle Regel für jede Workload übernommen werden.
Mit der Kyverno CLI lassen sich Regeln und ihre erwarteten Ergebnisse in der Pipeline testen. Ein solcher Policy-Test beantwortet, ob die Regel bestimmte Eingaben korrekt behandelt. Ein aktiv ausgeführtes Unterbrechungsszenario beantwortet eine zusätzliche Betriebsfrage.
Chainsaw kann auch echte Clusterabläufe testen
Die Aussage „Kyverno kann nur YAML prüfen“ wäre falsch. Das aus dem Kyverno-Umfeld stammende Chainsaw ist ein E2E-Testwerkzeug für Kubernetes. Tests können Ressourcen anwenden, Zustände prüfen und Befehle oder Skripte orchestrieren. Damit lassen sich auch reale Clusterabläufe in einer passenden Testumgebung untersuchen.
Wer heute einen Drain-Test, Assertions und eigene Lastmessungen damit verbindet, muss also nicht auf die neue Arbeitsgruppe warten. Das Team definiert dann selbst das Szenario, die zulässigen Berechtigungen, das Beobachtungsfenster und die Erfolgskriterien. Genau bei dieser Definition setzt die geplante gemeinsame Prüfbasis an.
Kubernetes hat bereits native Sicherheitsprüfungen
Auch „native Prüfung“ ist keine vollständig neue Idee. Pod Security Admission setzt die Pod Security Standards durch und ist seit Kubernetes 1.25 stabil. Dabei können Betreiber unter anderem zwischen Durchsetzung, Audit und Warnung unterscheiden sowie einen Versionsbezug festlegen.
ValidatingAdmissionPolicy ist seit Kubernetes 1.30 stabil. Es ermöglicht deklarative Validierung mit CEL im API-Server-Prozess und bietet damit für geeignete Prüfungen eine Alternative zu Validierungs-Webhooks. Dieser Ausführungsort ist eine echte Form nativer Integration.
Ein Admission-Mechanismus, ein gemeinsamer Anforderungsstandard und ein ausgeführter Laufzeittest haben jedoch verschiedene Aufgaben. Eine im API-Server ausgewertete Regel löst nicht von sich aus eine Wartungsübung aus. Umgekehrt muss eine gute Laufzeitprüfung nicht zwingend im API-Server implementiert sein.
Warum eine gemeinsame Upstream-Basis einen Unterschied machen kann
Unsere Einordnung: Der stärkste mögliche Vorteil von Workload Conformance ist ein gemeinsamer technischer Vertrag zwischen Anwendungsherstellern und Plattformteams. Das geht über die Entscheidung hinaus, welche Engine eine Regel ausführt.
1. Ein konkreter Bezug zur Kubernetes-Version
Eine Aussage wie „funktioniert unter Kubernetes“ ist für eine Upgrade-Entscheidung wenig präzise. Eine versionierte Spezifikation könnte genauer beschreiben, welche Anforderungen für die Zielversion geprüft wurden. API-Nutzung, bekannte Erwartungen und Teständerungen würden damit besser zuordenbar.
Die konkrete Version der Anwendung, ihre Konfiguration und die Testumgebung bleiben trotzdem Teil des Ergebnisses. Die Versionsnummer des Standards kann diesen Kontext nicht ersetzen.
2. Weniger unterschiedliche Definitionen derselben Basisfrage
Heute können mehrere Betreiber unter „wartungsfähig“ unterschiedliche Szenarien verstehen. Wenn Hersteller und Betreiber dieselben festgelegten Tests verwenden, lässt sich eine grundlegende Erwartung früher im Lieferprozess klären. Die Diskussion kann sich stärker auf verbleibende Unterschiede und unternehmensspezifische Anforderungen konzentrieren.
Das ist ein erwarteter organisatorischer Nutzen, keine bereits gemessene Zeitersparnis des neuen Projekts.
3. Prüfungen mit mehreren fachlichen Perspektiven
Workload-Verhalten berührt Anwendung, Scheduling, Netzwerk, Storage und Security. Eine gemeinsam gepflegte Upstream-Spezifikation bietet einen Ort, um diese Perspektiven zusammenzuführen. Das kann lokale Regelsätze um eine breiter abgestimmte Grundlage ergänzen.
Wie gut die späteren Tests reproduzierbar sind und welche Betriebskosten sie verursachen, muss sich mit den ersten Werkzeugen zeigen. Community-Governance allein löst diese technischen Schwierigkeiten nicht.
4. Mehr Freiheit bei der Umsetzung
Ein herstellerneutraler Prüfmaßstab kann mehrere Umsetzungen erlauben. Kyverno, andere Policy Engines, native Admission-Regeln und Testframeworks können weiterhin jeweils sinnvolle Aufgaben übernehmen. Betreiber brauchen zusätzlich ihre konkreten Regeln und Anwendungstests.
Deshalb ist „nativ integriert“ hier die falsche Zusage für den heutigen Stand. Belegt ist die Arbeit an einem Upstream-Standard mit Testwerkzeugen. Nicht belegt sind ein Einbau in kubelet oder API-Server, eine automatische Durchsetzung im laufenden Betrieb oder der Wegfall zusätzlicher Komponenten. Der mögliche Vorteil ist die gemeinsam gepflegte Definition, nicht eine grundsätzlich überlegene Engine.
Was Plattformteams schon jetzt sinnvoll vorbereiten können
Die Arbeitsgruppe bittet ausdrücklich um reale Erfahrungen aus Wartung und Upgrades. Wer einen konkreten Fall mit Rahmenbedingungen und beobachtetem Verhalten beschreibt, hilft der Standardisierung mehr als eine pauschale Forderung nach „mehr Resilienz“.
Für euren eigenen Bestand könnt ihr zunächst vorhandene Informationen zusammenführen:
| Fragestellung | Heute verwendbare Grundlage | Zusätzlich beobachtbares Verhalten |
|---|---|---|
| Darf die Instanz regulär unterbrochen werden? | PDB-Zuordnung und Controller-Einstellungen | Fortschritt des Wartungsablaufs bei definierter Kapazität |
| Wann ist die Ersatzinstanz bereit? | Probe-Konfiguration und Abhängigkeiten | Zeit bis zur nutzbaren Funktion im gewählten Szenario |
| Wie endet laufende Arbeit? | Beendigungslogik und Grace Period | Ergebnis bereits gestarteter Anfragen oder Aufträge |
| Welche Sicherheitsregeln gelten? | Pod Security Standards und eigene Policies | Reaktion auf gezielt abweichende Testkonfigurationen |
| Welche Plattformversion wird gebraucht? | Verwendete APIs und Komponenten | Verhalten auf der vorgesehenen Zielversion |
Diese Tabelle ist eine eigene Arbeitshilfe. Sie erklärt keine bestimmte Konfiguration zum künftigen Conformance-Standard.
Für die Bestandsaufnahme genügen zunächst lesende Abfragen, beispielsweise in einem ausgewählten Test-Namespace:
kubectl get deployments,pods,pdb -n <test-namespace> -o wide
kubectl get deployment <deployment-name> -n <test-namespace> -o yaml
kubectl get pdb <pdb-name> -n <test-namespace> -o yaml
Ein aktiver Unterbrechungstest gehört in eine geeignete Testumgebung oder ein ausdrücklich freigegebenes Wartungsszenario. Legt vorher fest, welche Workload betroffen ist, welche Last simuliert wird, welche Auswirkungen akzeptabel sind und wie der Test beendet wird. Die obigen Abfragen führen keine Eviction aus.
Was Workload Conformance für Cybersecurity und Sicherheitsmanagement bedeutet
Verfügbarkeit, unnötige Privilegien und inkompatible APIs betreffen den sicheren Betrieb. Der angekündigte Standard ist deshalb auch ein Thema für Cybersecurity. Er ist jedoch kein Penetrationstest, keine Prüfung der gesamten Geschäftslogik und kein Nachweis vollständiger Unternehmens-Compliance.
Ein technischer Befund braucht im Betrieb einen zuständigen Bereich und eine Entscheidung über seine Behandlung. Ein fehlgeschlagener Test kann eine Konfigurationsänderung, zusätzliche Kapazität oder eine Änderung der Anwendung auslösen. In manchen Fällen muss eine Einschränkung bewusst bewertet werden. Unsere Einordnung zur Neubewertung von Risiken beschreibt diese organisatorische Seite.
Kopexa kann diesen Arbeitszusammenhang abbilden: Risiken, Maßnahmen, Verantwortliche und Nachweise werden miteinander verbunden. Der Bericht eines technischen Werkzeugs kann dabei ein Eingang für den eigenen Prozess sein. Welche Daten sich über vorhandene Importwege oder die GraphQL-API übernehmen lassen, muss am konkreten Modell geprüft werden. Eine native Kyverno-Anbindung oder ein heute verfügbarer Workload-Conformance-Import wird hier nicht zugesagt.
Die technische Prüfung bleibt bei den dafür eingesetzten Werkzeugen. Wie ihr Beobachtung, Bewertung und weitere Bearbeitung auseinanderhaltet, zeigen wir auch im OSCAL-Praxisbeitrag.
Worauf es beim nächsten Projektstand ankommt
Die nächsten aussagekräftigen Schritte sind ein konkreter Anforderungskatalog, präzise beschriebene Tests und nachvollziehbare Ergebnisse an realen Workloads. Erst damit lässt sich bewerten, wie viel gemeinsame Basis entsteht und welche betriebliche Arbeit zusätzlich bleibt.
Bis dahin lohnt sich die Initiative als Diskussionsgrundlage: Hersteller und Betreiber könnten künftig klarer vereinbaren, welches Laufzeitverhalten sie voraussetzen und wie sie es prüfen. Bestehende Policies und Anwendungstests könnt ihr heute weiterentwickeln – und eure Erfahrungen in die entstehende Spezifikation einbringen.
Kurz beantwortet
Häufige Fragen
Noch eine Frage offen? Hier findest du die Antworten zum Nachlesen.
Was ist Kubernetes Workload Conformance?
Die Initiative soll einen gemeinsamen Standard für das Laufzeitverhalten von Anwendungen auf Kubernetes schaffen. Geplant sind eine Spezifikation je Kubernetes-Minorversion, objektive Prüfverfahren und passende Upstream-Testwerkzeuge. Der öffentliche Projektstand vom 27. Oktober 2026 enthält noch keine vereinbarten konkreten Anforderungen oder Testmethoden.
Ist der neue Workload-Check schon in Kubernetes eingebaut?
Nein. Angekündigt wurde eine Arbeitsgruppe mit geplanten Ergebnissen. Es gibt in den geprüften Projektquellen keine Zusage für einen bereits verfügbaren automatischen Check im API-Server oder kubelet. Zwei bis drei Releasezyklen sind das Ziel für eine erste stabile Spezifikation mit Tests, kein verbindlicher Auslieferungstermin.
Ersetzt Workload Conformance Kyverno oder Chainsaw?
Nein, das wurde nicht angekündigt. Kyverno setzt und prüft Richtlinien; Chainsaw kann echte Kubernetes-Testabläufe orchestrieren. Der zusätzliche Nutzen einer künftigen Workload-Conformance-Spezifikation wäre eine gemeinsame, versionsbezogene Definition der Anforderungen und Prüfungen. Eigene Betriebsregeln und fachliche Anwendungstests bleiben erforderlich.
Garantiert ein PodDisruptionBudget unterbrechungsfreien Betrieb?
Nein. Ein PDB begrenzt bestimmte freiwillige Unterbrechungen ausgewählter Pods. Es verhindert keine unfreiwilligen Node-Ausfälle und steuert nicht die Rolling Updates eines Workload-Controllers. Kapazität, Platzierung, Bereitschaft und Beendigungsverhalten der Anwendung müssen zusätzlich zum gewählten Betriebsszenario passen.
Warum wäre eine Upstream-Prüfbasis besser als ein eigener Regelsatz?
Sie könnte gemeinsame Erwartungen zwischen Softwareherstellern und Plattformbetreibern präzisieren: welche Anforderungen für eine Kubernetes-Version gelten und nach welchem Verfahren sie getestet wurden. Der Vorteil wäre Vergleichbarkeit und gemeinsame Pflege. Das macht eine vorhandene Policy Engine nicht grundsätzlich schlechter und ersetzt keine unternehmensspezifischen Regeln.
Kann Workload Conformance die Sicherheit einer ganzen Anwendung zertifizieren?
Das ist nicht der angekündigte Umfang. Die fachliche Anwendungslogik ist ausdrücklich ausgeschlossen. Technische Tests können konkrete geprüfte Eigenschaften belegen, aber weder vollständige Sicherheit noch Unternehmens-Compliance garantieren. Ein mögliches späteres CNCF-Zertifizierungsprogramm ist außerdem ein eigener Schritt und noch kein gestartetes Angebot.
Quellen
- Kubernetes: Announcing the Workload Conformance Working Group () [Abgerufen am ]
- Kubernetes Community: Workload Conformance Charter [Abgerufen am ]
- Kubernetes: Disruptions [Abgerufen am ]
- Kubernetes: Safely Drain a Node [Abgerufen am ]
- Kyverno: Applying Policies [Abgerufen am ]
- Kyverno: Testing Policies [Abgerufen am ]
- Kyverno Chainsaw: Kubernetes E2E testing [Abgerufen am ]
- Kubernetes: Pod Security Admission [Abgerufen am ]
- Kubernetes: Validating Admission Policy [Abgerufen am ]
- Kubernetes: Container Lifecycle Hooks [Abgerufen am ]
- Kubernetes: Liveness, Readiness and Startup Probes [Abgerufen am ]