Guide
RTO, RPO und MTPD: Wie viel Ausfall verträgt euer Prozess?
Leite Wiederanlauf und tolerierbaren Datenverlust aus dem Geschäftsprozess ab. Mit Rechenbeispiel, Zeitpuffer und Prüffragen für einen Wiederanlauftest.

„Vier Stunden Ausfall sind okay.“ Für wen, zu welchem Zeitpunkt und mit welchem Arbeitsumfang? Ohne diese Antworten wird aus einer Zahl schnell ein Versprechen, das niemand geprüft hat. RTO, RPO und MTPD helfen erst dann, wenn ihr sie aus einem konkreten Geschäftsprozess ableitet.
Drei Größen, drei unterschiedliche Fragen
Die MTPD beschreibt die maximal tolerierbare Unterbrechung eines Geschäftsprozesses. Danach wären die Auswirkungen nicht mehr tragbar. Die RTO ist das Ziel für den Wiederanlauf. Die RPO beschreibt, wie weit der verfügbare Datenstand zurückliegen darf, also welchen Datenverlust ihr toleriert. Der BSI-Standard 200-4, Kapitel 7 ordnet diese Größen der Business-Impact-Analyse zu.
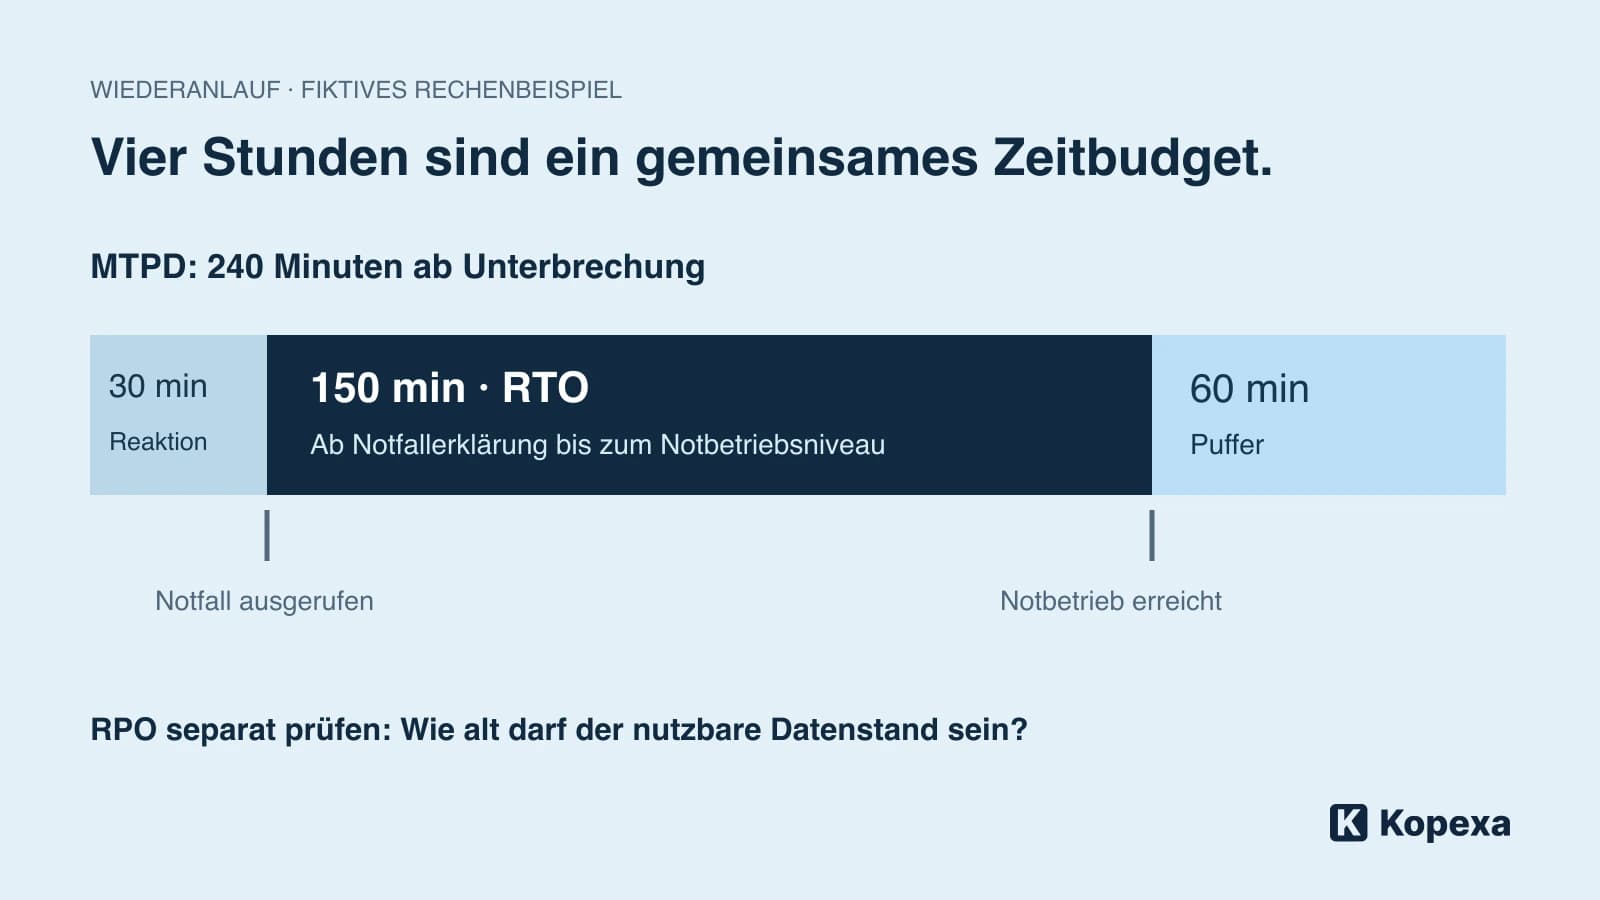
Beim BSI beginnt die RTO mit dem Ausrufen des Notfalls und endet mit der geforderten Inbetriebnahme der BC-Lösung. Reaktionszeit und zusätzlicher Puffer müssen daher in die maximal tolerierbare Ausfallzeit passen. Vereinbart den Bezugspunkt ausdrücklich: Eine technische Restore-Dauer ist nicht automatisch die RTO eines nutzbaren Geschäftsprozesses.
Unser Beispiel zeigt eine mögliche Planung. Die Zahlen sind fiktiv, keine Branchenvorgabe und keine Empfehlung für euren Betrieb.
Beginnt bei einer Leistung, nicht beim Server
Ein Ersatzteilhändler muss dringende Aufträge bestätigen und an das Lager übergeben können. Das Team untersucht den Ausfall während seiner besetzten Geschäftszeit. Nach vier Stunden drohen in diesem Beispiel nicht mehr tragbare Verzögerungen bei zugesagten Lieferungen. Die Verantwortlichen setzen die MTPD deshalb auf vier Stunden.
Diese Bewertung muss begründet sein. Prüft Lieferfenster, Verpflichtungen, Rückstände und die Möglichkeit, Arbeit nachzuholen. Ein Ausfall am Vormittag kann andere Folgen haben als derselbe Ausfall kurz vor Versandende. In der Business-Impact-Analyse zählt der Prozess mit seinen Abhängigkeiten, nicht die Bequemlichkeit eines vorhandenen Sicherungsplans.
Für den Händler bedeutet Notbetrieb zunächst: dringende Aufträge bearbeiten. Die volle Geschwindigkeit und alle Auswertungen müssen noch nicht wieder verfügbar sein. Ohne dieses Mindestniveau bleibt „wieder angelaufen“ mehrdeutig.
Das Zeitbudget durchrechnen
Das Team reserviert 30 Minuten für Erkennung, Bewertung und Ausrufen des Notfalls. Für den Wiederanlauf bis zum vereinbarten Notbetriebsniveau sind 150 Minuten vorgesehen. Eine weitere Stunde bleibt als Puffer.
| Abschnitt | Zeit im Beispiel | Ergebnis |
|---|---|---|
| Erkennen und entscheiden | 30 Minuten | Notfall ausgerufen, Verantwortliche arbeiten |
| Wiederanlauf: RTO | 150 Minuten | Dringende Aufträge sind wieder bearbeitbar |
| Reserve bis zur MTPD | 60 Minuten | Spielraum für Abweichungen |
| Maximal tolerierbare Unterbrechung | 240 Minuten | Grenze aus der betrieblichen Bewertung |
Die Rechnung lautet 30 + 150 + 60 = 240 Minuten. Der Puffer ist kein zusätzlicher Zeitraum nach der MTPD. Auch die Prüfung durch den Fachbereich gehört vor das Ende des Wiederanlaufs: Wenn die Datenbank nach zwei Stunden erreichbar ist, aber niemand Aufträge abschließen kann, ist das Ziel noch nicht erreicht.
Plant abhängige Schritte mit ein. Identitätsdienst, Netzwerk, Anwendung und Schnittstelle zum Lager können unterschiedliche Verantwortliche haben. Müssen Arbeiten nacheinander erfolgen, lassen sich ihre Zeiten nicht durch den schnellsten Einzelwert ersetzen.
Den zulässigen Datenverlust separat entscheiden
Im Beispiel dürfen höchstens 15 Minuten an Auftragsdaten fehlen. Das ist die vereinbarte RPO. Fragt den Fachbereich, wie diese Aufträge rekonstruiert werden könnten und welche Informationen dafür verfügbar bleiben müssten. Ein verlorener Auftrag ist etwas anderes als eine erneut erzeugbare Statistik.
Eine Sicherung alle 15 Minuten allein beweist die Einhaltung noch nicht. Wenn der letzte Job fehlgeschlagen oder sein Ergebnis unbrauchbar ist, liegt der letzte nutzbare Datenstand weiter zurück. Prüft deshalb im Test den tatsächlich wiederhergestellten Stand und dessen fachliche Konsistenz.
Ebenso wichtig: Die RPO sagt nichts darüber aus, wie schnell ihr die Daten zurückbekommt. Ein sehr aktuelles Backup kann zu lange für den Restore brauchen. Umgekehrt kann ein schneller Restore einen zu alten Stand liefern.
Ein Test muss die Arbeit abbilden
Legt vor dem Test fest, woran ihr den Erfolg erkennt. Für unseren Händler wären das drei dringende Testaufträge, die sich korrekt erfassen, bestätigen und an das Testlager übergeben lassen. Verwendet eine geeignete Testumgebung und Daten, mit denen keine echten Lieferungen ausgelöst werden.
Das Protokoll sollte Startpunkte, Unterbrechungen, verfügbare Datenstände und die fachliche Abnahme enthalten. Eine verfehlte Zeit ist ein Ergebnis, kein Anlass, das Ziel nachträglich passend zu rechnen. Entscheidet dann zwischen besserer Wiederanlauflösung, anderem Notbetrieb oder einer begründeten Neubewertung des Geschäftsbedarfs.
In Kopexa könnt ihr die BIA und die betroffenen Assets mit Risiken und Maßnahmen verbinden. Testprotokolle gehören als Nachweise an die Maßnahmen. So bleibt sichtbar, welche Lücke das Team schließen muss. Für die nächste Risikobewertung zählt der gemessene Ablauf, nicht nur der geplante Wert.
Nächster Schritt: Wählt einen zeitkritischen Prozess. Lasst Fachbereich und IT gemeinsam sagen, welche Leistung nach dem Wiederanlauf funktionieren muss. Erst danach legt ihr die Zahlen fest.
Quellen
- BSI-Standard 200-4: Business Continuity Management, Kapitel 7 [Abgerufen am ]